Açık kaynaklı yapay zekâ "yardımcı bilim insanı" OpenScientist, beş biyomedikal çalışmada uzman denetiminde sınandı
Washington Üniversitesi ve Berkeley Lab öncülüğündeki ekip, veriden analiz yapıp hipotez kuran açık kaynaklı yapay zekâ ajanı OpenScientist'i Nature Medicine'de tanıttı. Sistem Alzheimer kan testi gibi beş örnek çalışmada insan analizlere yakın sonuçlar verdi, işleri dakikalar ya da saatler içinde bitirdi. Ancak uydurma kaynak ve veride olmayan analiz gibi hatalar, uzman denetiminin şart olduğunu gösteriyor.
Bir biyomedikal araştırmacının elinde çoğu zaman analiz etmeye vakit bulamadığı yığınla veri vardır: binlerce kan proteini ölçümü, tek tek nöronlardan okunmuş gen ifadeleri, yıllar süren hasta takipleri. Washington Üniversitesi (St. Louis) ile ABD Enerji Bakanlığı'na bağlı Lawrence Berkeley Ulusal Laboratuvarı'nın öncülük ettiği geniş bir ekip, bu yükü hafifletmek için geliştirdiği açık kaynaklı yapay zekâ ajanı OpenScientist'i Nature Medicine dergisinde 16 Kasım 2026'da tanıttı. Sistem, bilim insanının yazdığı bir soruyu alıyor; literatürü tarıyor, hipotez kuruyor, analiz kodunu kendisi yazıp çalıştırıyor ve sonunda kodu ve kaynaklarıyla birlikte denetlenebilir bir rapor sunuyor. Alan uzmanlarının değerlendirdiği beş örnek çalışmada OpenScientist, Alzheimer kan testlerinin başarısını insan ekiple aynı değerle ölçtü, ölüm riskini öngören bir model kurdu ve yeni hipotezler önerdi. Yazarlara göre insanların haftalar, hatta aylar süren emeğini isteyen analizler dakikalar ya da birkaç saat içinde tamamlandı. Ama makalenin ek dosyaları, sistemin uydurma kaynak gösterdiği ve istatistikte tökezlediği örneklerle de dolu; ekip aracı bilim insanının yerine geçen bir makine olarak değil, uzman denetiminde çalışan bir yardımcı olarak sunuyor.
"Yardımcı bilim insanı" tam olarak ne yapıyor?
OpenScientist, kendi başına bir dil modeli değil; büyük dil modellerini bir iş akışına bağlayan bir "ajan" yazılımı. Kullanıcı araştırma sorusunu yazıyor, isterse bir veri dosyası ve proje belgeleri (örneğin hibe başvurusu) ekliyor. Ajan önce PubMed'de konuyla ilgili makaleleri arayıp okuyor, ardından sınanabilir hipotezler kuruyor, bunları sınayacak istatistik kodunu yazıyor ve yalıtılmış bir yazılım kapsayıcısında çalıştırıyor. Her bulgu, hangi turda ve hangi kanıta dayanarak elde edildiğiyle birlikte "bilgi durumu" (knowledge state) adı verilen bir kayda işleniyor. Döngü varsayılan olarak yaklaşık 10 tur sürüyor; "ortak araştırmacı" kipinde bilim insanı turlar arasında yorum yazıp analizi yönlendirebiliyor.
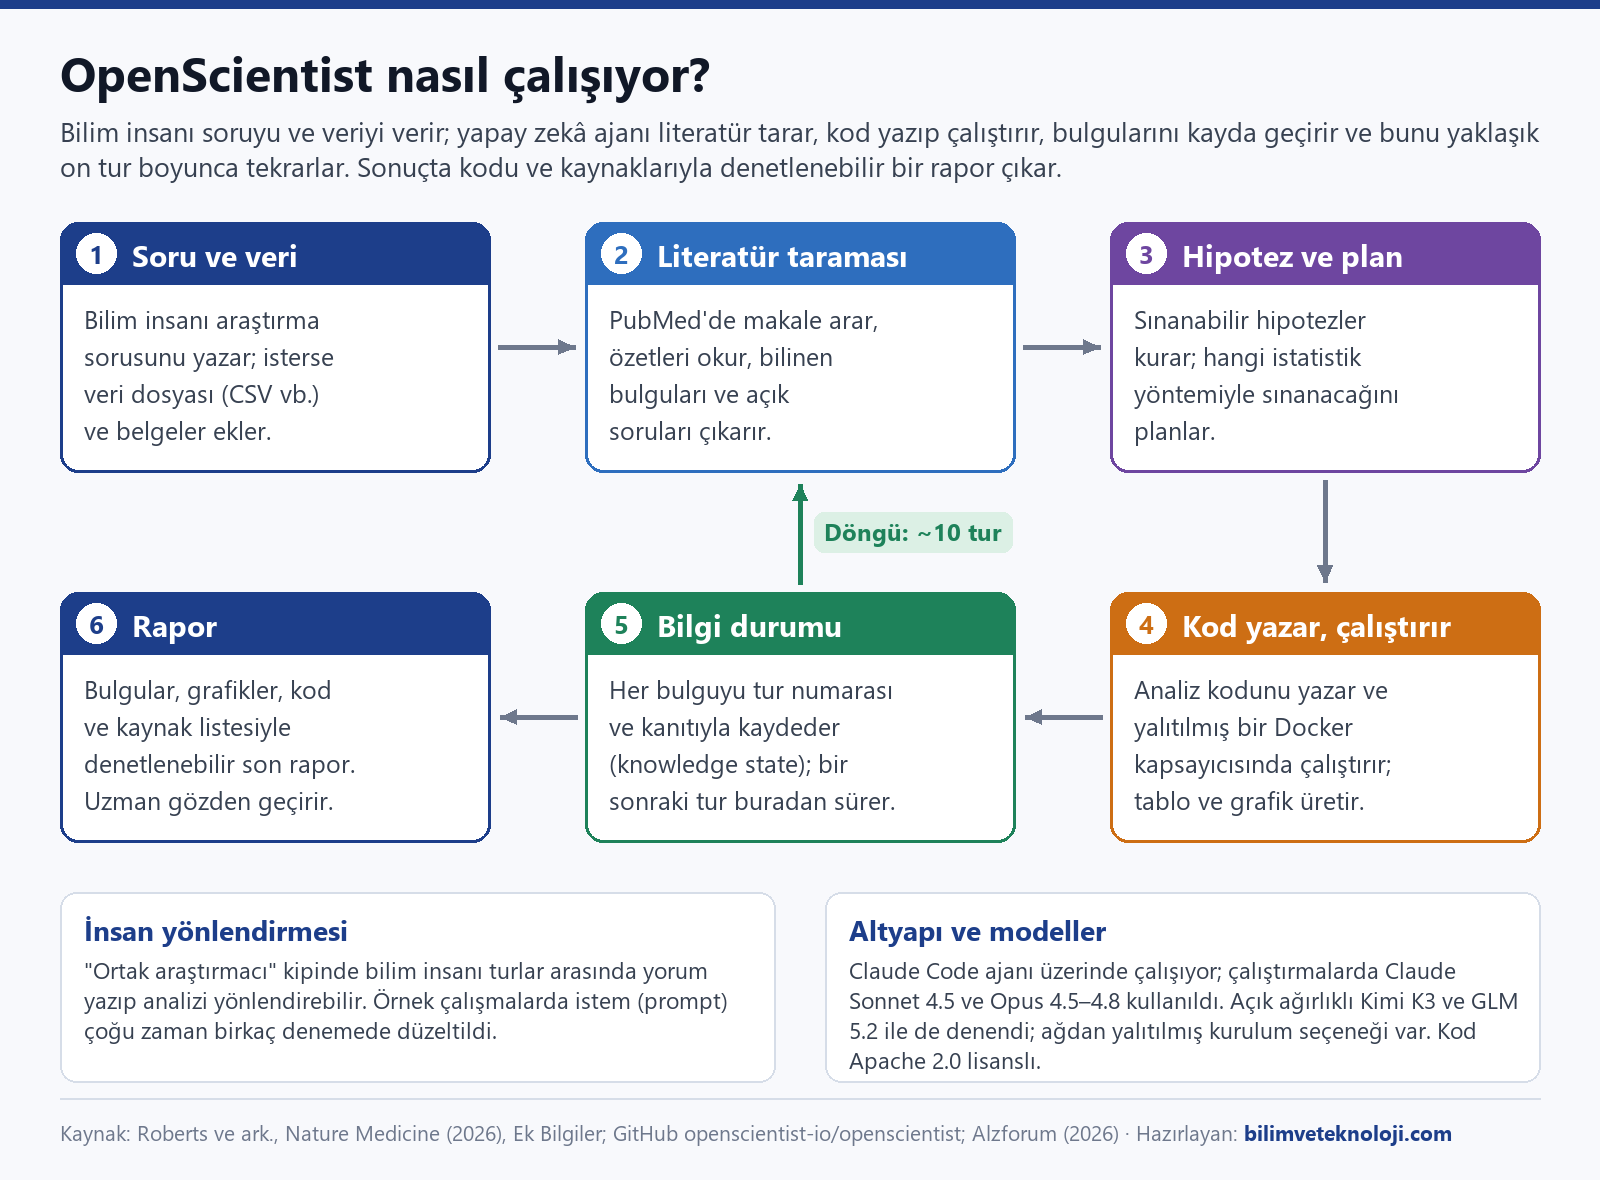
Sistemin altyapısı Anthropic'in kodlama ajanı Claude Code. Makalenin ek tablolarına göre Kasım 2025 ile Şubat 2026 arasındaki geliştirme döneminde yapılan 93 çalıştırmanın büyük kısmında Claude Opus 4.5, bir kısmında Claude Sonnet 4.5 kullanıldı; sonraki tekrar deneylerinde Opus 4.6 ve 4.8 devreye girdi. Ekip, hassas hasta verisi kullanan kurumlar için önemli bir seçeneği de denedi: Moonshot AI'ın Kimi K3 ve Zhipu'nun GLM 5.2 gibi ağırlıkları açık modellerle, internet bağlantısı kesilmiş ("air-gapped") bir kurulumda çalışmak. Yazılımın kodu GitHub'da Apache 2.0 lisansıyla yayımlanıyor; ilk sürüm (0.1.0) Mart 2026'da, 0.2.0 sürümü ise makaleyle aynı gün yayımlandı. Kullanıcı ajanın her adımını, yazdığı kodu ve okuduğu kaynakları görebiliyor.
Projenin arkasında, Washington Üniversitesi'nden nörolog Randall Bateman'ın kurucusu olduğu ve Kasım 2025'te çalışmaya başlayan C-BRAIN adlı konsorsiyum (Nörodejenerasyonda Biyomedikal Araştırma ve Yapay Zekâ Konsorsiyumu) var. Yazılımı geliştiren ekibe Berkeley Lab'den Justin Reese liderlik ediyor; makalenin yazışmadan sorumlu yazarları da Bateman ile Reese. Yazar listesinde Harvard Tıp Fakültesi, Stanford, Seattle'daki Washington Üniversitesi, Londra'daki UK Demans Araştırma Enstitüsü ve İsviçre'deki Fribourg Üniversitesi'nden araştırmacılar da yer alıyor.
Alzheimer kan testinde insan ekiple aynı sonuç
Değerlendirmenin en net örneği Alzheimer hastalığıyla ilgili. Dünya Sağlık Örgütü'ne göre dünyada 57 milyon kişi demansla yaşıyor (2021 verisi) ve vakaların yüzde 60–70'inden Alzheimer sorumlu. Hastalığın erken izi olan beyindeki amiloid birikimini bugün en güvenilir biçimde pahalı PET taramaları gösteriyor; bu yüzden aynı bilgiyi basit bir kan testinden okumak alanın en çok uğraşılan hedeflerinden biri.
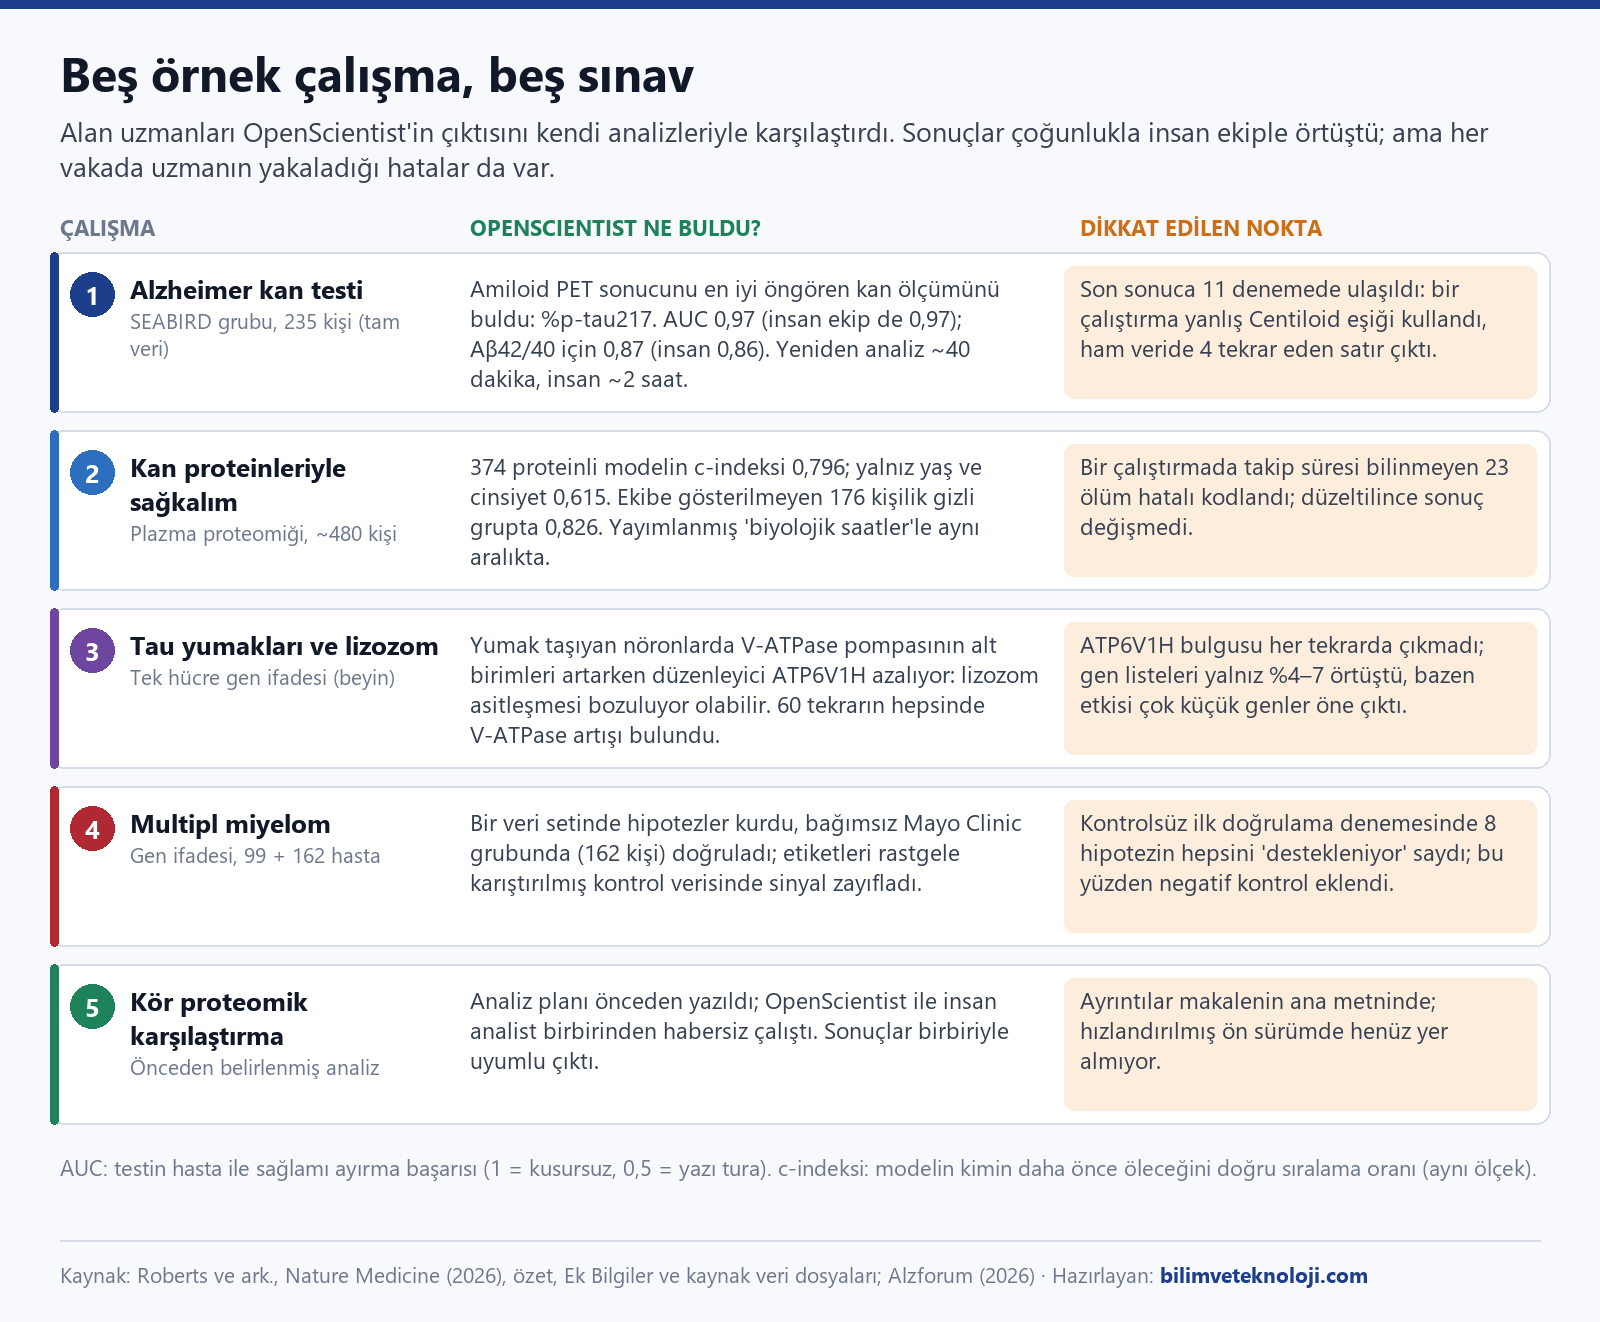
Ekip, OpenScientist'e Washington Üniversitesi'nin toplum tabanlı SEABIRD çalışmasının henüz yayımlanmamış verilerini ve çalışmanın hibe planını verdi; sorulan şey, hangi kan ölçümünün amiloid PET sonucunu en iyi öngördüğüydü. Tüm ölçümleri eksiksiz olan 235 kişide yapılan analizde OpenScientist, p-tau217 adlı proteinin fosforlu oranının amiloidi en iyi ayırt eden ölçüm olduğunu buldu. Testin hasta ile sağlamı ayırma başarısını gösteren AUC değeri hem yapay zekânın hem de çalışmanın insan analistlerinin hesabında 0,97 çıktı. Ön baskı dönemindeki sunumlarda verilen bilgiye göre bu yeniden analiz yapay zekâyla yaklaşık 40 dakika, insan ekiple yaklaşık iki saat sürdü; özgün analiz ise haftalar almıştı.
Ancak bu sonuca tek seferde varılmadı. Ek tablolar, SEABIRD analizinin 11 kez çalıştırıldığını gösteriyor. Bazı çalıştırmalar amiloid pozitifliği için yanlış bir eşik değeri seçti, birinde son rapor sonuç aralığını hatalı yazdı; ham veride dört satırın tekrarlandığı da bu süreçte ortaya çıktı ve insan ekip tarafından temizlendi. İstem (prompt) her seferinde biraz daha daraltıldı.
Sağkalım, tau yumakları ve miyelom: diğer dört sınav
İkinci örnekte OpenScientist'ten, 18 ile 99 yaş arasındaki yaklaşık 480 kişinin kan proteini ölçümlerinden kimin daha önce öleceğini öngören bir model kurması istendi. Sistemin kurduğu 374 proteinli modelin c-indeksi (doğru sıralama oranı) 0,796 oldu; yalnız yaş ve cinsiyete dayanan modelin değeri 0,615'te kaldı. Bu sonuç, alanda kullanılan GrimAge, PhenoAge gibi yayımlanmış "biyolojik yaş saatleri"yle aynı aralıkta. Daha güçlü sınav, verinin bir bölümünün ekipten tamamen saklandığı ayrı bir çalıştırmaydı: OpenScientist'in eğitim verisinden çıkardığı altı proteinli puan, görmediği 176 kişilik gizli grupta 0,826 değerine ulaştı. Bir çalıştırmada takip süresi bilinmeyen 23 ölümün hatalı kodlandığı da uzmanlar tarafından fark edildi; düzeltme sonucu değiştirmedi.
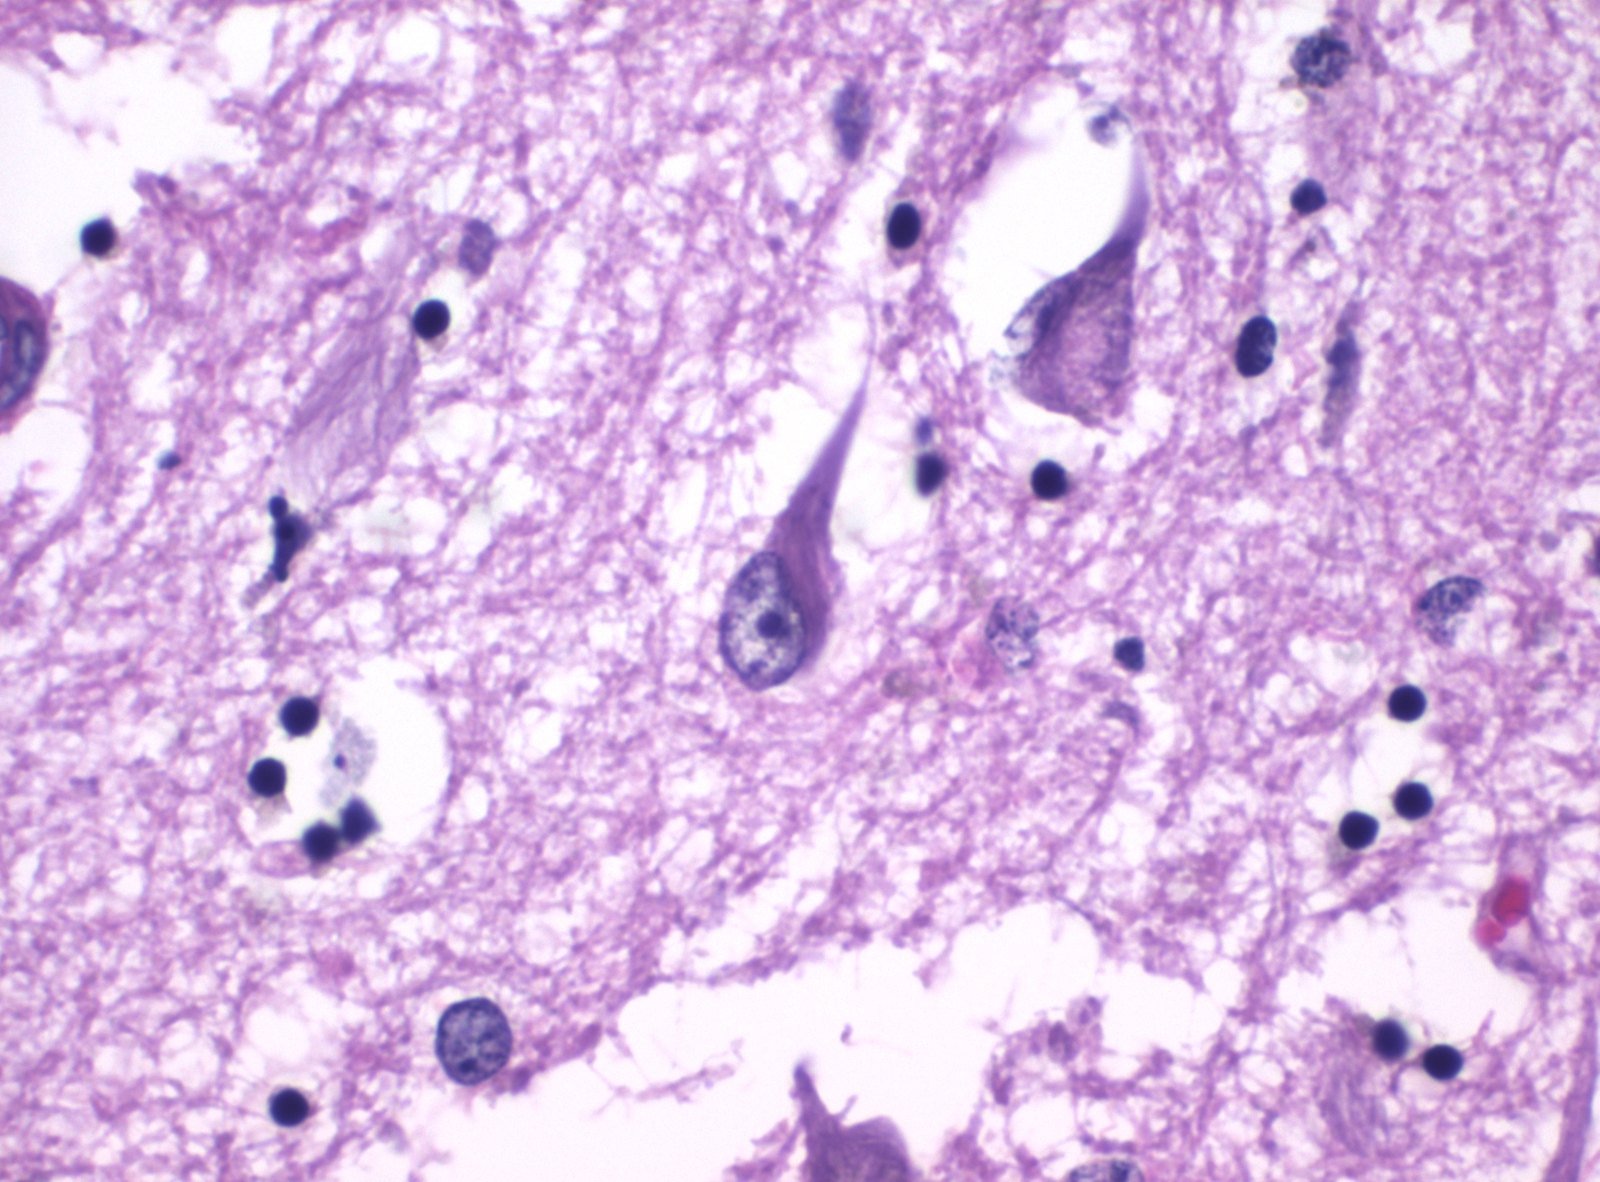
Üçüncü örnek, Alzheimer'ın ikinci ana izi olan tau yumaklarıyla ilgiliydi. Yumak taşıyan ve taşımayan nöronların tek tek okunmuş gen ifadelerini inceleyen OpenScientist, hücrenin "çöp öğütücüsü" lizozomun içini asidik tutan V-ATPase pompasıyla ilgili bir çelişkiye dikkat çekti: Pompanın enerji üreten alt birimlerinin genleri daha çok okunurken, pompanın doğru kurulması için gereken düzenleyici ATP6V1H alt biriminin geni azalıyordu. Bu da yumaklı nöronlarda lizozomun asitleşmesinin bozulabileceğini düşündürüyor. Ekip aynı soruyu farklı model ve ağ ayarlarıyla 60 kez sordu; raporların hepsi V-ATPase genlerinin daha çok okunduğunu ve hücrenin protein kalite denetim ağının genel olarak harekete geçtiğini buldu. Düzenleyici alt birimdeki düşüş ise ayrı bir on tekrarlık denemenin yalnız altısında rapora girdi. Yazarlar yine de bunun doğrudan ölçülmüş bir pH değişimi değil, deneyle sınanması gereken bir mekanizma önerisi olduğunu vurguluyor.
Dördüncü örnekte kan kanseri multipl miyelomda bir veri setinden hipotezler üretildi ve bunlar Mayo Clinic'in 162 hastalık bağımsız verisinde sınandı. Hipotezler bu dış grupta doğrulandı; hasta etiketlerinin rastgele karıştırıldığı kontrol verisinde ise sinyal zayıfladı. Bu negatif kontrolün eklenme nedeni de öğretici: Kontrol olmadan yapılan bir doğrulama denemesinde sistem, sınadığı sekiz hipotezin hepsini "destekleniyor" diye raporlamıştı. Beşinci örnekte ise analiz planı önceden yazıldı ve OpenScientist ile bir insan analist aynı proteomik veriyi birbirinden habersiz inceledi; sonuçlar birbiriyle uyumlu çıktı. Bu son karşılaştırmanın ayrıntıları makalenin ana metninde; derginin hızlandırılmış ön sürümünde henüz yer almıyor.
Dakikalar, saatler ve birkaç on dolar
Makalenin en çok dikkat çeken iddiası hız. Ön baskı döneminde yapılan sunumlara göre sağkalım modeli yaklaşık üç saatte kuruldu; Reese, aynı işin bir biyoistatistikçinin iki ila dört haftasını alacağını tahmin ediyor. Bu karşılaştırmaların insan tarafının ölçülmüş değil, araştırmacıların tahmini olduğunu not etmek gerekiyor.
Maliyet de düşük sayılır. Ek tabloda her çalıştırma için kullanılan modelin token tüketiminden hesaplanmış bedel veriliyor. Bizim bu tablodan yaptığımız hesaba göre maliyeti yazılı 87 çalıştırmanın ortancası yaklaşık 11 dolar; yarıya yakını 10 doların altında, en pahalısı (bir beyin görüntüsü analizi) 117 dolar. C-BRAIN ile çalışan Nvidia'nın Ekim 2026 tarihli duyurusunda ise "çalıştırma başına 10 doların altında" ifadesi geçiyor.
Uydurma kaynaklar ve aşırı yorum: hatalar nerede?
Makalenin değerli yanı, başarıların yanında başarısızlıkları da ayrıntılı tablolarla belgelemesi. Ek bilgilerdeki sekizinci örnekte, beyin omurilik sıvısı proteinleri üzerine yorum isteyen ilk çalıştırmada OpenScientist'in gösterdiği sekiz kaynaktan altısının başlığı ya da yazarları yanlıştı; hiçbirinde DOI yoktu. Aynı raporda veri setinde bulunmayan üç gen varmış gibi yorumlandı, bazı yolak adları değiştirildi, bazı sayılar hatalı aktarıldı. Güncellenmiş sürümle yapılan sonraki çalıştırmada kaynaklar düzeldi.
Plasebo yan etkileri üzerine kurulan başka bir sınavda sistem, Excel dosyasındaki sayımları kusursuz yaptı; ancak dosyada hiç bulunmayan ilaç sınıfı, organ sistemi gibi bilgilere dayanan analizleri de sonuç diye raporladı. Tau çalışmasının tekrarlarında ise ajan zaman zaman etkisi çok küçük genleri, yalnızca istatistiksel olarak anlamlı oldukları için biyolojik yoruma kattı. Altmış tekrarın hepsi aynı ana sonuca ulaşsa da raporlarda adı geçen gen listeleri birbiriyle yalnızca yüzde 4–7 oranında örtüştü. Yani sonucun yönü kararlı, ama ajanın hangi ayrıntıyı seçtiği her çalıştırmada değişiyor. Yazarlar, ajanın analiz talimatlarını içeren "beceri" dosyaları iyileştirildiğinde bazı istatistik hatalarının belirgin biçimde azaldığını da gösteriyor.
Ağdan yalıtılmış kurulumla ilgili bir çekince de var: Testte açık modeller, uygun donanım bulunmadığı için Microsoft'un bulut servisi üzerinden çalıştırıldı; yani sistem henüz tamamen yerel bir ortamda sınanmadı. Bir de değerlendirmenin kendisi: Örnek çalışmaları seçen ve sonuçları puanlayan, aracı geliştiren ekip ve iş birlikçileri. Mart 2026'daki ön baskıda multipl miyelom sonucu "gerçek sinyali rastgele kontrolden ayırdı" diye özetlenirken, hakem sürecinden geçmiş son metin kontrol verisinde sinyalin "zayıfladığını" söyleyen daha temkinli bir ifade kullanıyor. Aracın değerini asıl, bağımsız ekiplerin kendi verileriyle yapacağı denemeler gösterecek.
Google'dan Sakana'ya: yapay zekâ bilim insanları yarışı
OpenScientist bu alandaki ilk deneme değil. Yapay zekânın bilimdeki en ünlü başarısı, DeepMind'ın protein yapısı tahmin eden AlphaFold'u; sistem Kasım 2020'deki CASP14 yarışmasında öne çıktı ve 2024 Nobel Kimya Ödülü'nün yarısını Demis Hassabis ile John Jumper'a getirdi. Son iki yılda ise hedef tek bir problemi çözen araçlardan, araştırma sürecinin tamamını yürütmeye çalışan ajanlara kaydı. Japon girişimi Sakana AI, Ağustos 2024'te fikirden makaleye her aşamayı otomatikleştirmeyi amaçlayan "The AI Scientist"i duyurdu; makalesi Mart 2026'da Nature'da yayımlandı. Google'ın Gemini tabanlı "AI co-scientist"i Şubat 2025'te tanıtıldı; FutureHouse'un Robin sistemi de Mayıs 2025'te kuru tip sarı nokta hastalığı için bir ilaç adayı önerdi. Bu iki sistemin makaleleri 19 Mayıs 2026'da Nature'da aynı gün çıktı; ikisi de önerilerini laboratuvar deneyleriyle kısmen doğruladı.
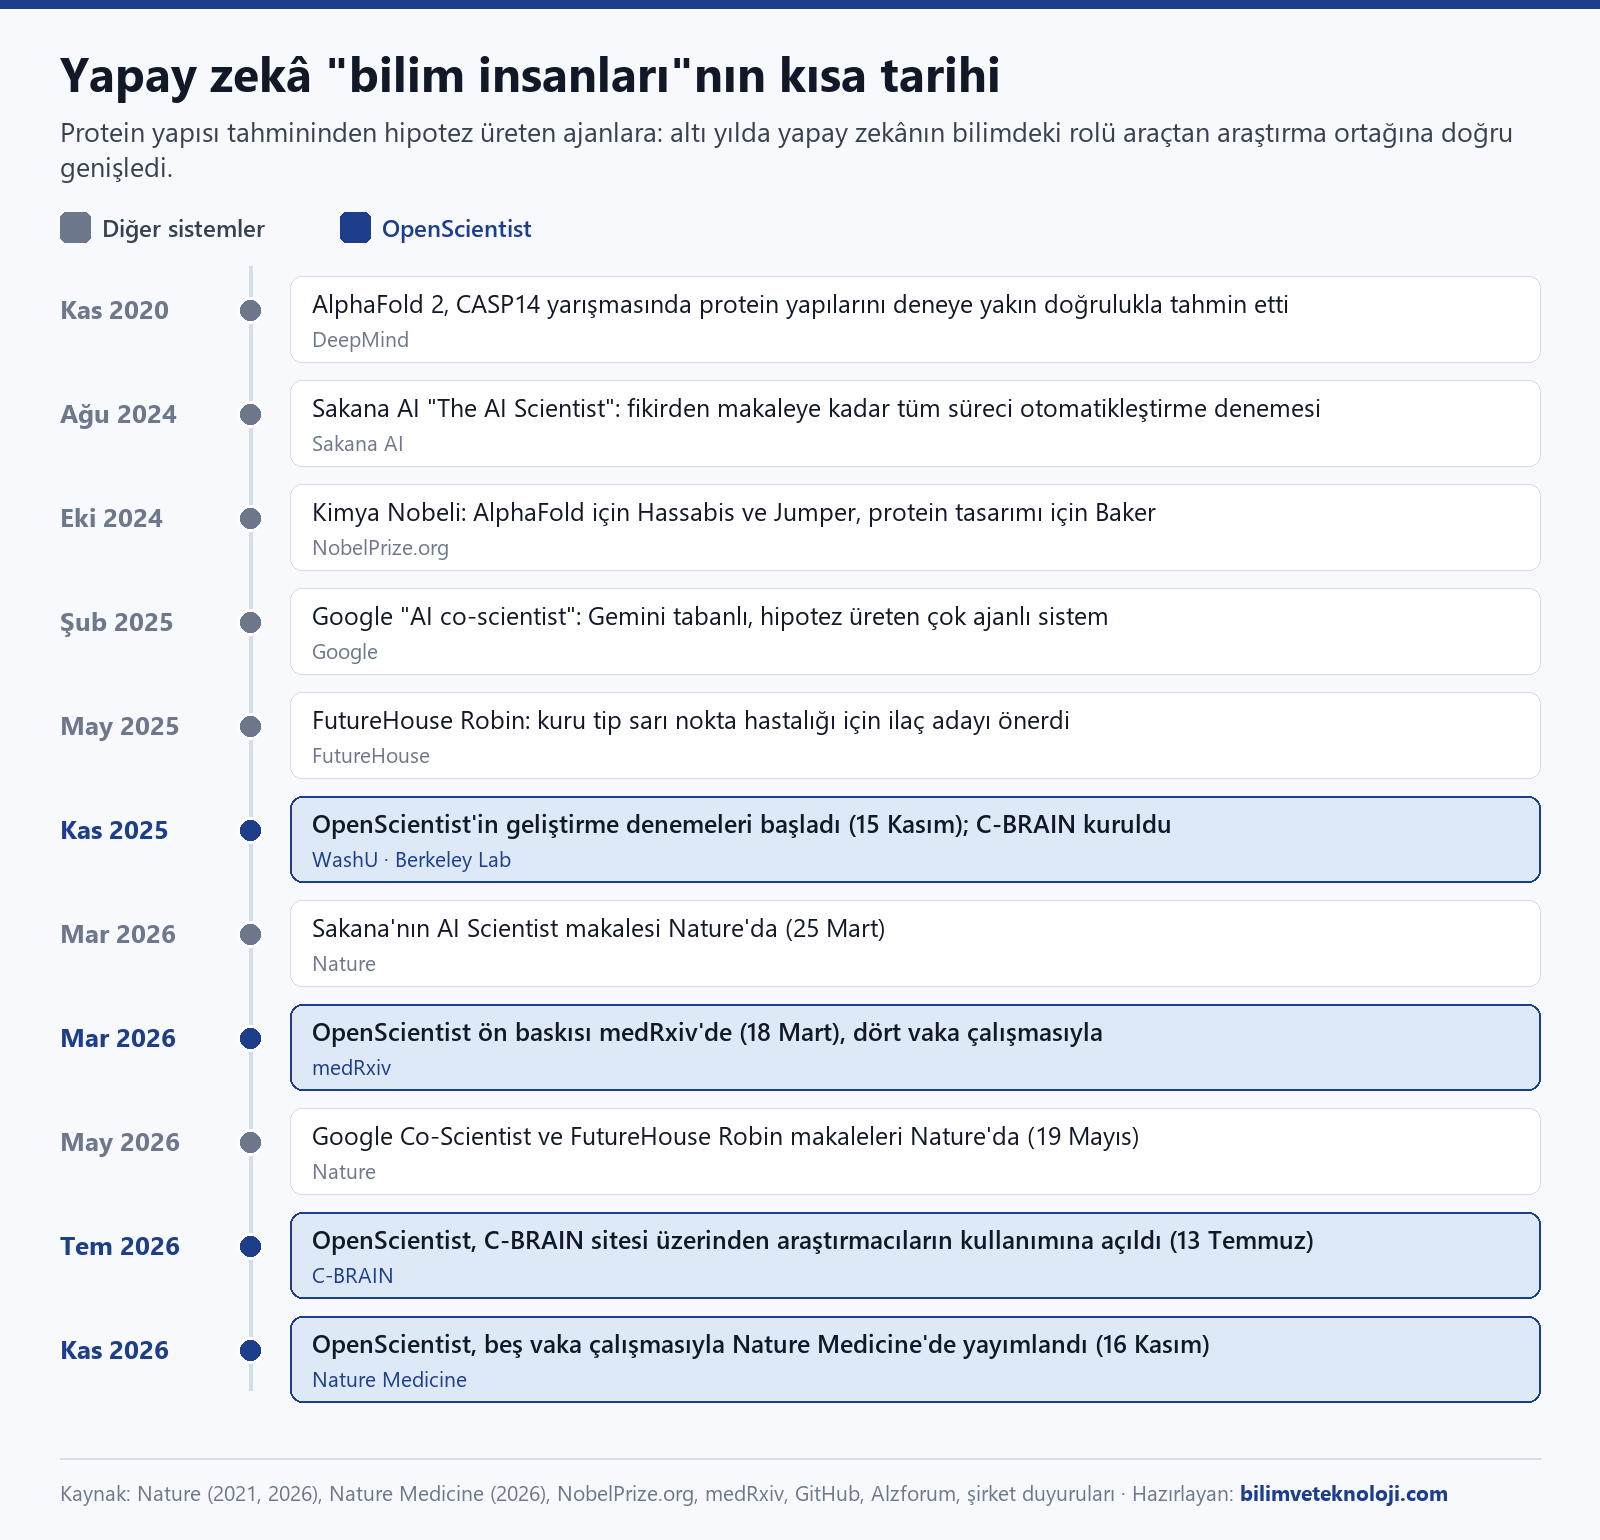
OpenScientist'i bu sistemlerden ayıran iki şey var. Birincisi açıklık: Kodun tamamı herkese açık ve kurumlar sistemi kendi sunucularında, isterlerse açık modellerle kurabiliyor. İkincisi odak: Google ve FutureHouse'un Nature makaleleri daha çok yeni hipotez üretip bunları laboratuvarda sınamaya odaklanırken, OpenScientist gerçek klinik verilerin analizine, yani bir laboratuvarın her gün yaptığı işe yöneliyor. C-BRAIN, aracı Temmuz 2026'da kendi sitesi üzerinden araştırmacıların ücretsiz kullanımına açtı.
Sırada ne var?
Ekibin vardığı sonuç ölçülü: OpenScientist, uzmanlarla birlikte çalıştığında biyomedikal veri analizini hızlandırabilir, ama çıktılarının her biri hâlâ bir insanın gözünden geçmeli. Önümüzdeki dönemde yanıt bekleyen sorular belli. Ağırlıkları açık modeller tamamen yerel donanımda aynı başarıyı gösterebilecek mi? Hastane gibi hassas veri barındıran kurumlar bu tür ajanlara verilerini emanet edecek mi? Uydurma kaynak ve aşırı yorum gibi hatalar, bağımsız ekiplerin rastgele seçtiği sorularda ne sıklıkla ortaya çıkacak? Ve belki en önemlisi: Yapay zekânın önerdiği tau–lizozom mekanizması ya da miyelom hipotezleri laboratuvar deneylerinde doğrulanacak mı?
Kaynaklar: Roberts K.F., Abrams Z.B., Cappelletti L. ve ark., "An open agentic AI co-scientist for clinical and biomedical discovery", Nature Medicine (16 Kasım 2026, hızlandırılmış ön sürüm), DOI 10.1038/s41591-026-04808-6, ile Ek Bilgiler ve kaynak veri dosyaları; aynı ekibin medRxiv ön baskısı (18 Mart 2026), DOI 10.64898/2026.03.15.26348338; OpenScientist GitHub deposu (openscientist-io/openscientist); Alzforum, C-BRAIN çalıştayı (7 Nisan 2026) ve C-BRAIN araçları (24 Temmuz 2026) haberleri; Nvidia blogu (27 Ekim 2026); Dünya Sağlık Örgütü demans bilgi notu; Lu C. ve ark., Nature (25 Mart 2026); Gottweis J. ve ark., Nature (19 Mayıs 2026); Ghareeb A.E. ve ark., Nature (19 Mayıs 2026); NobelPrize.org, 2024 Kimya Ödülü. Maliyet ortancası bilimveteknoloji.com'un makalenin Ek Tablo 1'inden yaptığı hesaptır.
Kapak fotoğrafı: ABD Ulusal İnsan Genomu Araştırma Enstitüsü'nde (NHGRI) bir araştırmacı mikro tüpten pipetle DNA örneği alıyor, 29 Temmuz 2004. Maggie Bartlett / NHGRI, kamu malı (Wikimedia Commons).